Satya Nadella:微软的 AGI 计划与量子突破
Satya Nadella — Microsoft's AGI plan & quantum breakthrough
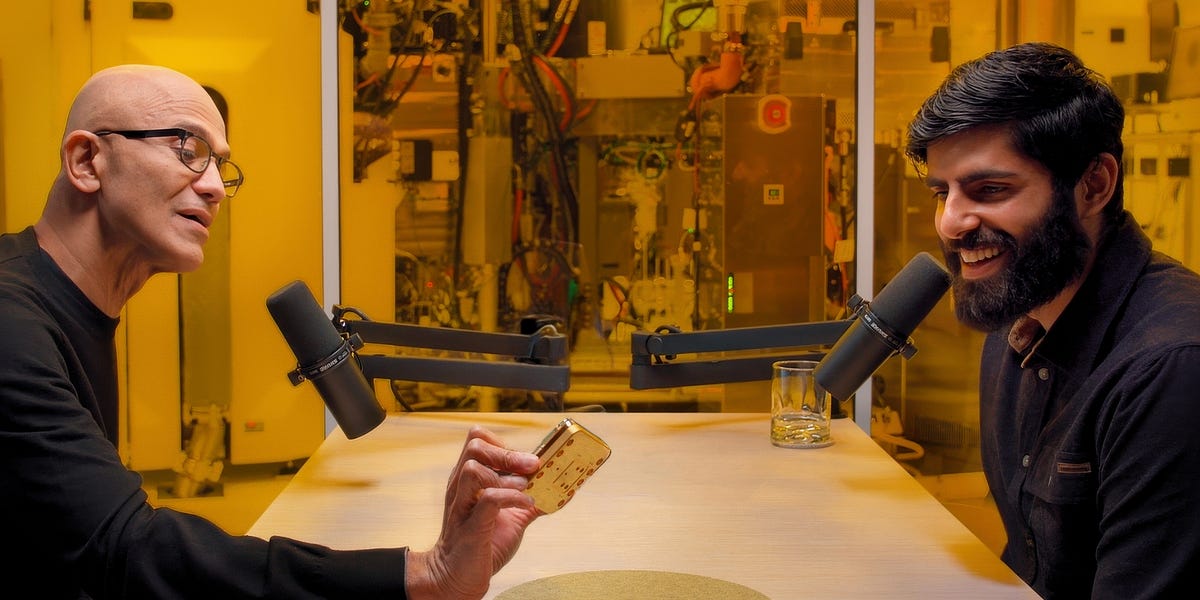
Satya Nadella —— 微软的 AGI 计划与量子突破。AGI 并非真正的 benchmark:10% 的经济增长才是。
Satya Nadella 谈及:为何他不相信 AGI,却相信 10% 的经济增长;微软在拓扑量子比特和游戏世界模型上的新突破;究竟是 Office 让 LLM 商品化,还是反之;在 Youtube 上观看;在 Apple Podcasts 或 Spotify 上收听。
Scale 与 Meta、Google Deepmind 和 OpenAI 等主要 AI 实验室合作。通过 Scale 的 Data Foundry,这些实验室可以获得高质量数据,用于 post-training,包括高级推理能力。如果你是 AI 研究者或工程师,欢迎了解 Scale 的 Data Foundry 及其研究实验室 SEAL 如何帮助你超越当前前沿,请访问 scale.com/dwarkesh。
Linear 的项目管理工具已成为 Ramp、CashApp、OpenAI 和 Scale 等公司产品团队的首选。这些团队使用 Linear,是为了能贴近产品、快速迭代。如果你好奇为何这么多公司正在转向 Linear,请访问 linear.app/dwarkesh。
如需赞助未来的节目,请访问 dwarkeshpatel.com/p/advertise。
(0:21:39) —— 智能的价格下降 (1:10:46) —— Satya Nadella 相信 AGI 吗?
Dwarkesh PatelSatya,非常感谢你来参加播客。我们马上就会谈到微软刚刚取得的两大突破,恭喜你们,同一天登上了 Nature:Majorana zero chip,它现在就摆在我们面前,还有 world human action models。但我们能不能先继续刚才的话题?你正在描述的是,你在八九十年代看到的那些现象,如今又再次上演了。
Satya Nadella让我兴奋的是……Dwarkesh,首先,能来你的播客太棒了。我是你的忠实听众,我很喜欢你做访谈的方式,以及你探讨的广泛话题。让我兴奋的是……这让我想起了我进入科技行业最初几年的情形,我是说从 90 年代开始,当时人们真的在争论到底会是 RISC 还是 CISC,或者,“嘿,我们真的能用 x86 构建服务器吗?”我加入微软时,正是 Windows NT 的起点。所以从核心硅片平台到操作系统,再到应用层——这种全栈方式——整个体系都在经历重新论证。你可以说云计算完成了其中很多变革,显然分布式计算和云计算确实改变了 client-server 架构。互联网也带来了巨大变化。但这一次感觉更像是——至少就我参与过的历史而言——比以往任何一次都更“全栈”。
Dwarkesh Patel当你回想八九十年代哪些决策最终成为长期赢家、哪些没有时,尤其是想到——你曾在 Sun Microsystems 工作,他们在 90 年代互联网泡沫中有一段有趣的经历。人们说当时数据中心的建设是一场泡沫,但与此同时,我们今天拥有的互联网正是得益于那时搭建的基础设施。关于什么能经受住时间考验,有什么经验教训?什么是固有的长期趋势?什么只是昙花一现?
Satya Nadella如果回顾我参与过的几次重大变革,首先是客户端和 client-server。那是图形用户界面的诞生,以及 x86 架构让我们能够构建服务器。这一点在当时对我来说非常清楚。我记得 91 年参加了当时所谓的 PDC,实际上那时我还在 Sun。91 年,我去了 Moscone。那是微软首次描述 Win32 接口的时候,我当时就很清楚接下来会发生什么:服务器也会变成 x86 的。
当规模优势向某一方聚集时,那就是你必须押注的长期趋势。客户端发生的事情,也会在服务器端发生,然后你就能真正构建 client-server 应用了。所以应用模型变得清晰起来。接下来是互联网,这是我们必须应对的大事,实际上就在我加入微软后不久,Netscape 浏览器或者说 Mosaic 浏览器就问世了,我想是在 93 年 12 月或 11 月,对吧?我记得就是 Andreessen 那帮人推出的。
那是一个巨大的游戏规则改变者,有趣的是,就在我们即将在 client-server 浪潮中大展拳脚之际,而且我们显然也会赢得那一波。我们迎来了浏览器时刻,因此必须做出调整。我们适应得相当不错,因为浏览器是一种新的应用模型。我们在所有产品中都拥抱了它,无论是在 Word 中支持 HTML,还是我们自己打造一款名为浏览器的新产品并参与竞争,再在我们的服务器堆栈上构建 web server 去争夺市场。
当然,我们错失了后来证明是互联网上最大的商业模式,因为我们都以为互联网的核心在于去中心化,谁能想到搜索会成为组织网络的最大赢家?所以那一点我们显然没看到,而 Google 看到了,并且执行得极为出色。这对我来说是一个教训:你不仅要把握技术趋势,还要看清价值将随着这一趋势在哪里创造。这些商业模式的转变,可能比技术趋势本身的变化更难把握。
Dwarkesh PatelAI 的价值将在哪里被创造?
Satya Nadella这是个好问题。我认为有两个地方我比较有信心。一是表现优异的超大规模云服务商(hyperscalers),因为从根本上说,如果你回溯 Sam 和其他人的描述,如果智能是计算量的对数函数(log of compute),那么谁拥有大量计算能力,谁就是大赢家。另一个有趣之处在于,如果你审视任何 AI 工作负载的底层,比如拿 ChatGPT 来说,大家并非只对 GPU 层面的进展感到兴奋,那当然很棒。
实际上,我甚至把我的整个基础设施舰队看作 AI accelerator、存储和计算之间的比例关系。而在大规模场景下,你必须让它同步增长。因此,世界对基础设施的需求将呈指数级增长。事实上,拥有这些 AI 工作负载简直是天降甘露,因为你知道吗?它们对计算的渴求更甚,不仅限于训练阶段,我们现在知道还包括 test time。当你想到 AI agent 时,结果发现 AI agent 将指数级地增加计算使用量,因为你不再受限于单个人类调用一个程序。
而是一个人类调用程序,这些程序再调用更多程序。这将催生对计算基础设施的巨大需求和大规模扩展。因此,我们的超大规模业务、Azure 业务,以及其他超大规模云服务商,我认为这是件大事。再往后,事情就变得有点模糊了。你可能会说,嘿,存在一个赢家通吃的模型——但我看不出这一点。顺便说一句,这是我学到的另一件事:非常善于理解哪些市场是赢家通吃的、哪些不是,从某种程度上说,这就是一切。我记得在 Azure 早期,Amazon 拥有非常显著的领先优势,人们会来找我,投资者也会来找我,说:“哦,游戏结束了。
你永远做不起来。Amazon 这是赢家通吃。”由于在 client-server 时代曾与 Oracle 和 IBM 竞争,我知道买家不会容忍赢家通吃。从结构上看,超大规模云永远不会是赢家通吃的,因为买家很聪明。消费市场有时可以是赢家通吃的,但只要买家是公司、企业、IT 部门,他们就会想要多个供应商。所以你得成为多个供应商之一。
我想,即便是在模型层面,情况也会如此。会出现开源方案,也会出现一种制衡力量。就像在 Windows 上一样,我学到的一个重要教训是:如果你有一个闭源操作系统,必然会出现一个与之互补的开源方案。
因此,这在某种程度上是对事态发展的真正制约。我认为在模型领域,有一点是确定的——也许会有少数闭源模型,但肯定会有开源替代方案,而这个开源替代方案实际上会确保闭源一方赢家通吃(winner-take-all)的局面得到缓解。
这是我在模型层面的感受。另外,别忘了,如果这东西真的像人们说的那么强大,国家是不会坐视不管、等着私营公司在全世界……到处行动的。所以,我不认为这会是一个赢家通吃的局面。
再往上层看,我觉得还会是那些老规律:在消费端,某些品类可能会出现赢家通吃的网络效应。毕竟,ChatGPT 就是一个很好的例子。
它是一个已经达到消费级规模的产品,已经具备了真正的逃逸速度(escape velocity)。我去 App Store 一看,它总是排在前五,我会说:“哇,这太不可思议了。”
所以他们能够利用早期的优势,并将其转化为应用层面的优势。在消费端,这种情况是可能发生的。而在企业端,我认为同样会按品类出现不同的赢家。至少我是这样分析的。
我还有很多追问。我们马上得谈谈量子计算,但关于模型可能会被商品化(commoditized)的观点:也许几十年前就有人对云计算提出过类似的论点——从根本上说,不过就是芯片和箱子。
但最终,显然你和许多其他人都搞清楚了如何在云计算中获得惊人的利润率。你们找到了实现规模经济和增加其他价值的方法。从根本上讲,哪怕抛开那些术语,如果你拥有了 AGI,而它正在帮你制造更好的 AI——现在是合成数据和 RL;未来也许是一个自动化的 AI 研究员——这似乎是一个巩固你在该领域优势的好方法。我很好奇你怎么看这一点,就是说,保持领先真的很重要,这个想法。
一旦上了规模,就没有什么是商品。就你提到的云计算而言,人人都会说:“哦,云计算是商品。”但问题是,当你规模化之后……这就是为什么运营超大规模云服务商(hyperscaler)的专有技术如此重要……你可能会说:“哦,有什么大不了的?我不过就是上架堆叠服务器罢了。”
事实上,在超大规模计算的早期,大多数人都认为:“有那么多主机托管商,而那些生意都不怎么样。这还会有什么前途吗?超大规模计算里真的有生意可做吗?”结果证明,这确实是一门真正的生意,恰恰是因为运营的专有技术——以 Azure 为例,要运营覆盖 60 多个区域的全球计算网络。这绝非易事,很难复制。
所以我真正想表达的是:赢家只有一个吗?这是不是赢家通吃?因为你必须把这一点判断对。我喜欢进入那些 TAM 足够大的领域,在那里你不必承担一切都是赢家通吃的风险。最好的处境就是身处一个足够大的市场,能容纳几个赢家,而你是其中之一。
这就是我所说的超大规模层。在模型层,首先,模型最终需要在某种超大规模计算上运行。所以我觉得这种关联将永远存在。不仅仅是模型本身;模型需要状态(state),这意味着它需要存储,它还需要常规算力来运行这些 agent 和 agent 环境。
因此,我是这样看的:为什么一个人靠一个模型通吃一切、包揽所有的情况可能不会发生,原因就在于此。
在超大规模厂商这边,顺便一提,你们作为超大规模厂商所具备的优势也挺有意思,尤其是考虑到推理时间 scaling(inference time scaling),以及如果这被用于训练未来的模型,你们可以摊薄数据中心和 GPU 的成本——不仅用于训练,还可以再次用于推理。
我很好奇,你认为 Microsoft 和 Azure 属于哪一类超大规模厂商?是在预训练(pre-training)这一侧?是在提供 O3 类型的推理?还是说,你们只是打算托管和部署市场上出现的任何模型,对此保持一种中立态度?
这是个好问题。我们希望打造基础设施集群的方式是,在某种意义上顺应摩尔定律(Moore's law)。我觉得这会像我们过去对待其他所有事情一样:每年持续更新集群,按照这些设备的生命周期价值进行折旧,然后极其擅长集群的部署安排,让你可以用高利用率来运行不同的任务。有时会有非常庞大的训练任务,需要高度集中的峰值 flops,并且要确保这些算力能够协同工作。这很好。我们应该有足够的数据中心足迹来提供这种能力。
但说到底,这些规模都变得如此之大,即便是预训练规模,如果要继续推进,预训练规模在某种程度上也必须跨越数据中心的边界。基本上就是这么回事。
所以,很好,一旦你开始跨越预训练的数据中心边界,这和其他事情还有什么不同呢?我的想法是,嘿,分布式计算依然是分布式的,所以去建设你的集群吧,让它能够为大型训练任务做好准备,为测试时计算(test-time compute)做好准备,事实上——如果 RL 那边真有大量需求的话,你先训出一个大模型,然后之后会有大量的 RL 在进行。对我来说,这更像是更多的训练 flops,因为你要为不同任务创建这些高度专门化、蒸馏过的小模型。
所以你需要那样的集群,以及推理服务的需求。说到底,光速就是光速,你不能在德克萨斯州建一个数据中心,然后说:“我要从那里服务全世界。”
你必须通过在世界各地都部署推理集群来服务全球。这就是我们建设真正的超大规模集群的思路。
哦,顺便说一下,我希望我的存储和计算也贴近所有这些设施,因为并非只有 AI 加速器是无状态的。我的训练数据本身需要存储,然后我希望能够 multiplex 多个训练任务,我希望拥有内存,我希望拥有这些环境,让 agent 可以在其中执行程序。我大致就是这么想的。
你们最近披露,AI 带来的年收入是 130 亿美元。但如果看看这块业务的同比增长,大概四年后就会翻 10 倍。如果趋势持续,你们将拥有 1300 亿美元的 AI 收入。如果真到了那一步,你预计会如何处理所有这些智能、这种工业规模的运用?
是通过 Office 来实现吗?还是通过你们部署给别人托管?你们必须拥有 AGI 才能达到 1300 亿美元的收入吗?这会是什么样子?
我是这么看的,Dwarkesh,这是个很好的问题,因为从某种程度上说,如果你将迎来这场爆发、这种丰裕——随便你怎么称呼——智能变得唾手可得,我们首先必须观察的是 GDP 增长。
在谈 Microsoft 的收入会是什么样之前,所有这一切只有一个制约因素(governor)。这正是我们在 AGI 热潮中有点过于超前的地方。记住,发达世界现在的增长率是多少?2%,如果扣除通胀,基本就是零?
所以,在 2025 年,当我们坐在这里,我不是经济学家,但至少我看待这件事的方式是:我们面临着真正的增长挑战。因此,当我们说这就像工业革命时,我们所有人都必须做的第一件事就是,让我们实现工业革命那种级别的增长。
在我看来,真正的标志是:10%、7%,发达国家经通胀调整后达到5%的增长。不能只是供给侧的繁荣。
事实上,这正是关键所在——很多人正在写这方面的内容,我很高兴他们这么做:这里的大赢家不会是科技公司,而是那些更广泛地使用这种商品(顺便说一句,这种商品是充裕的)的行业。突然间生产率提高了,经济增速加快了。当那一刻到来时,我们作为一个行业也会过得很好。
但对我来说,那个时刻才是真正的标志。我们自我宣称达到了某个AGI里程碑,那只是毫无意义的刷分。真正的基准是:世界以10%的速度增长。
好吧,那么如果世界以10%的速度增长,全球经济规模大概在100万亿美元左右,若增速达到10%,那就相当于每年额外产出10万亿美元的价值。如果是这样,作为一家hyperscaler……800亿美元看起来似乎是一大笔钱,你不是应该投到8000亿美元量级才对吗?
如果你真的认为,再过几年我们就能让世界经济以这样的速度增长,而关键瓶颈将是:你是否有足够的compute来部署这些AI,让它们完成所有这些工作?
确实如此。但顺便说一句,经典的供给侧逻辑是:“嘿,让我先建起来,他们自然会来。”这是一种说法,毕竟我们已经这么做了,也冒了足够的风险去实践。
但在某个时刻,供给和需求必须对应上。这就是为什么我两边都在跟踪。如果你只顾用供给侧逻辑给自己造势,而不真正理解如何将其转化为对客户的实际价值,那你可能完全脱轨。
这就是为什么我会关注我的inference revenue。这也是我为什么要披露inference revenue的原因之一……有趣的是,没有很多人在谈论他们的真实收入,但对我来说,这是衡量你如何思考这件事的重要调节器。
你并不会说它们必须在任何一个时间点上完全对称地匹配,但你需要一个存在性证明,证明你能够用昨天的——姑且称之为资本——转化为今天的需求,这样你才能再次投资,甚至可能是指数级地投资,同时清楚自己不会完全出现节奏错配。
我想知道这两种不同观点之间是否存在矛盾,因为你做得非常好的一件事就是下了这些早期赌注。你在2019年就投资了OpenAI,甚至比Copilot和任何应用出现还要早。
如果你看看工业革命,那些6%、10%增长的铁路建设之类的东西,很多都不是像“我们已经有了票务收入,现在我们要……”那样开始的。
确实如此。所以,如果你真的认为这里有潜力把世界增长率提高到10倍或5倍,然后你却在问“GPT-4的收入是多少?”
如果你真的认为下一个层级有这种可能性,你不是应该直接“让我们疯狂一把,让我们投入数千亿美元的compute”吗?我是说,总有机会的,对吧?
有意思的是,对吧?这就是为什么即使是对fleet采取那种平衡的方法,至少对我来说也非常重要。重点不是建造compute,而是建造能够真正帮助我的compute——不仅用于训练下一个大模型,还要用于服务下一个大模型。在你同时做到这两点之前,你都无法真正处于能够变现甚至利用你投资的位置。
所以,关键就在这里:这不是一场仅仅为了建造模型的竞赛,而是一场创造一种在世界上被使用的商品的竞赛,以推动……你必须有一个完整的思路,不能只想一件事。
顺便说一句,其中之一就是会出现过度建设。说到你提到的互联网时代发生的事,备忘录已经发出去了:嘿,你需要更多能源,你需要更多compute。谢天谢地。所以,大家都会竞相投入。
事实上,不仅仅是公司在部署,国家也会投入资金,而且显然会有……我很高兴能成为一个出租方,因为顺便说一句,我建了很多,也租了很多。我很高兴我将在2027、2028年出租大量容量,因为我看着这些建设,我说:“这太棒了。”所有这些compute建设唯一会带来结果就是价格会下降。
说到价格下降,在DeepSeek模型出来后,你最近发了一条关于杰文斯悖论(Jevons’ Paradox)的推文。我很好奇你能否详细阐述一下。杰文斯悖论发生在某种东西的需求具有高度弹性时。智能真是因为价格下降而受到瓶颈限制吗?
因为当我从消费者的使用场景来考虑时,智能已经够便宜了。大约每百万token两美分。我真的需要它降到0.02美分吗?我真正的瓶颈在于它能不能变得更聪明。如果你需要向我收100倍的费用,那就做100倍大的training run。我很乐意让公司这么做。
但也许你在企业端看到了不同的情况。智能的关键使用场景到底是什么,真的需要它降到每百万token 0.002美分吗?
我认为真正重要的是token的效用。两者都需要发生:一是智能需要变得更好、更便宜。而且任何时候只要有突破,就像DeepSeek所做的那样,每token性能的efficient frontier发生变化,曲线就会弯曲,前沿就会移动。这只会带来更多需求。云时代就是这样发生的。
有意思的是:我们过去认为“天哪,我们在client-server时代已经卖掉了所有服务器”。但一旦我们开始把服务器放到云端,突然人们开始消费更多,因为他们可以更便宜地购买,而且它是弹性的,他们可以按使用量付费而不是买许可证,这完全扩大了市场。
我记得去过,比如说,像印度这样的国家,跟他们介绍“这是SQL Server”。我们卖了一点,但天哪,印度的云市场比我们能在服务器时代做的任何事情都要大得多。我认为这将会重演。
想想看,如果你想真正让Global South的发展中国家拥有这些用于医疗健康、非常便宜的token,那将是有史以来最大的变革。
我觉得有人听到像我这样在旧金山的人说话,认为“他们有点傻;他们不知道在现实世界中部署东西到底是什么样的”,这非常合理。
作为与这些Fortune 500公司合作、并正在与它们合作为数亿乃至数十亿人部署东西的人,你觉得这些能力的部署速度会有多快?
即使你已经有了能工作的agent,即使你已经有了能为你做远程工作的东西,面对所有的合规要求和所有固有的瓶颈,这会是一个巨大的瓶颈,还是会很快过去?
这将是一个真正的挑战,因为真正的问题是change management或process change。有意思的是:我用的一个类比是,想象一下像我们这样的跨国公司在PC、email和spreadsheets出现之前是怎么做预测的。传真到处传。然后有人拿到那些传真,写一份内部备忘录再到处传,人们输入数字,然后最终一份预测报告出来了,可能刚好赶上下一个季度。
然后有人说:“嘿,我要拿一个Excel spreadsheet,放在email里,发给大家。人们会去编辑它,然后我就能有一份预测报告了。”所以,整个预测业务流程都改变了,因为工作产物和工作流程改变了。
AI被引入knowledge work时,也需要发生同样的变化。事实上,当我们思考所有这些agent时,最根本的是出现了新的工作方式和工作流程。
比如说,就连准备这次播客的时候,我也会去找我的 Copilot,说:“嘿,我要跟 Dwarkesh 聊聊我们关于量子计算的发布,还有我们搭建的这个用于游戏生成的新模型。给我汇总一下,去之前我该读哪些材料。”它知道是那两篇 Nature 论文,就采用了这些资料。我甚至还说:“嘿,用播客对谈的形式给我讲一遍。”结果它模拟我们俩聊这个话题,做得还挺好。
于是这就成了一种——事实上,后来我还把它分享给了团队。我把它放进 Pages 里,那是我们的 artifact,然后发了出去。所以对我来说,新的工作流程就是:带着 AI 思考,并与同事协作。
这对所有从事知识工作的人来说,都是一场根本性的变革管理——大家突然要去摸索新的模式:“我要怎么用全新的方式完成知识工作?”这需要时间。销售、财务、供应链,各个领域都会经历这个过程。
对一家成熟企业而言,我认为这会是这样一种情形——你知道,我喜欢用一个类比,就是制造业当年对 Lean 的采用。我很喜欢这个类比,因为从某种意义上说,Lean 变成了一套方法论,告诉你如何拿住制造业的端到端流程,让它变得更高效。也就是持续改进,减少浪费、提升价值。
同样的变革将发生在知识领域。这特别像是知识工作领域的 Lean。这将是管理团队和每一位知识工作者的艰巨任务,也需要时间慢慢沉淀。
我能简要追问一下这个类比吗?Lean 做的一件事,是从物理上改变了工厂车间的样貌。它暴露出了人们此前未曾察觉的瓶颈,直到你真正去关注流程和工作流。
你简要提到了自己的工作流程——AI 如何改变了你自己的工作流程。我好奇的是,我们能不能再多描绘一下:当你拥有这些越来越聪明的 AI agent 时,经营一家大公司会是什么样子?
你问这个很有意思。比如我今天就在想,我们现在邮件负担很重。早上一到公司,我就心想,哎呀,收件箱又满了,得回复,所以我特别期待有些 Copilot agent 能自动帮我生成草稿,这样我就可以审阅并发送。
不过我现在在 Copilot 里已经有至少十个 agent,针对不同的任务,我会向它们查询不同的事情。我觉得未来会出现一种新的“收件箱”:我手头数以百万计的 agent 需要向我提请例外情况、发通知、请求指令。
所以至少我目前的想法是,需要一种新的架构,也就是 agent manager。它不能只是一个聊天界面。我需要一个比聊天界面更智能的东西,来管理所有 agent 以及它们的对话。
这就是为什么我认为 Copilot 作为 AI 的 UI,是一件非常、非常重要的事。我们每个人都会有这样一个东西。基本上可以这样想:存在知识工作,也存在知识工作者。知识工作可以由许许多多的 agent 来完成,但你仍然需要一位知识工作者去统筹所有这些知识工作者。而这,我认为就是人们必须去构建的界面。
你是世界上少数能说自己拥有 20 万……你身边环绕着一大群智能体,也就是 Microsoft 这家公司及其全体员工。你必须管理他们,必须与他们交互,思考如何充分利用。希望未来世界上更多人都能获得这种体验。
我好奇的是,你的收件箱——如果这意味着每个人的收件箱——会不会变得像你早上看到的那样。
好,在聊那个之前,我还想继续多问你一些 AI 的问题,但我真的很想问问 Microsoft Research 宣布的量子计算重大突破。你能解释一下这是怎么回事吗?
对我们来说,这又是长达 30 年的旅程。难以置信。我是 Microsoft 第三任对量子计算充满热情的 CEO。
这里的关键突破,或者说我们一直以来的愿景是:要建造一台真正可用的 utility-scale 量子计算机,你需要物理学上的突破。我们选择的路径是,要获得噪声更低或更可靠的 qubit,办法就是押注一种本身就更加可靠的物理特性,而这正是我们走向 Majorana zero modes 的原因——这一概念在 1930 年代就被理论预言了。问题在于,我们能否真正在物理上制造出这些东西?我们能不能把它们造出来?
所以真正的重大突破,我知道你跟 Chetan 聊过,就是我们终于拥有了 Majorana zero modes 的存在性证明,以及在一种全新的物质相态中实现的物理学突破。这就是为什么我们喜欢用类比,把这视为量子计算的 transistor moment——我们实际上拥有了一种新的相态,即 topological phase,这意味着我们现在能够可靠地隐藏量子信息、测量它,而且我们能够将其制造出来。既然我们已经做到了这一点,我们觉得随着这项核心基础制造技术的攻克,我们可以开始打造 Majorana chip 了。
这个 Majorana One 基本上将是第一枚能够承载一百万个物理 qubit 的芯片。在此基础上,还有数千个经过纠错处理的 logical qubit。然后一切就真正开始了。你突然之间就具备了建造一台真正的 utility-scale 量子计算机的能力,而在我看来,现在这变得可行得多了。没有这样的突破,你或许仍能达成一些里程碑,但永远无法建造出 utility-scale 的计算机。这就是我们如此兴奋的原因。
太惊人了。顺便说一句,我想就是这个,就在这里。
我忘了,我们现在是叫它 Majorana 吗?对,没错。Majorana One。我很高兴我们用了这个名字。
想想看,我们居然能在这么小的东西里造出一台百万 qubit 级别的量子计算机,简直不可思议。这才是关键所在:除非且直到我们能做到这一点,否则你根本无法奢望建造一台 utility-scale 的量子计算机。
你是说最终那百万个 qubit 会放到这么大小的一枚芯片上?好的,太厉害了。
其他公司已经宣布做到了 100 个物理 qubit,Google、IBM 还有其他公司。你说你宣布的是“一个”,但你的意思是你们的方案在极限情况下更具可扩展性。
是的。我们还有一件事,就是我们采取了一种将软件和硬件分离的方法。我们正在构建软件栈,并且现在与 neutral atom 团队、ion trap 团队合作,也在与其他一些公司合作,他们在 photonics 等方面有很好的方案,这意味着未来会有不同类型的量子计算机。事实上,我们上一次宣布的成果,我记得是 24 个 logical qubits。所以我们在 error correction 方面也取得了一些非常棒的突破,正因如此,即使是在 neutral atom 和 ion trap 量子计算机上,我们也已经能建造出 20 多个 logical qubits,而且我认为今年这一数字还会持续提升;你会看到我们不断提高这一标杆。
但我们同时也说:“让我们回到第一性原理,打造我们自己的量子计算机,押注 topological qubit。”而这就是此次突破的核心。
太惊人了。百万个 topological qubit、数千个 logical qubit,要达到这个规模的预计时间线是怎样的?如果你已经拥有了第一颗 transistor,这里的 Moore's law 会是什么样?
显然,我们已经为此努力了 30 年。我很高兴我们现在拥有了物理学突破和制造突破。
真希望我们有一台量子计算机,因为顺便说一句,量子计算机能让我们做的第一件事,就是去建造量子计算机本身;因为模拟这些新型量子门的原子级构造将会变得容易得多。
但无论如何,接下来真正要做的是,既然我们已经掌握了制造工艺,那就去建造第一台容错量子计算机。这才是合乎逻辑的方向。
所以,我现在可以说:「哦,也许到 2027、2028、2029 年,我们真能把它造出来。」既然我们有了这一种量子门,我能把它放进集成电路,然后再把这些集成电路装进一台真正的计算机吗?这就是下一步合乎逻辑的进展。
那么在你看来,到 2027、2028 年,如果它运行起来了,它会是一个通过 API 访问的东西吗?还是你们会把它用于材料和化学领域的内部研究?
这是个好问题。让我兴奋的一点是,即使在当今的世界里……我们有一个量子项目,并且为它添加了一些 API。大概两年前,我们的突破在于把 HPC 技术栈、AI 技术栈和量子计算放在一起考量。
事实上,仔细想想,AI 就像是模拟器的仿真器,而量子计算则像是自然界的模拟器。量子计算会用来做什么呢?顺便说一句,量子计算不会取代经典计算。量子计算擅长做它自己擅长的事,经典计算同样也会……
对于任何不重数据、但重状态空间探索的事情,量子计算都会非常出色。它应该是轻数据、重探索的,适合探索指数级的状态。模拟就是一个很好的应用场景:化学物理、各类相关领域,还有生物学。
我们已经开始做的一件事,是真正把 AI 当作仿真引擎。然后你可以进行训练。所以我的想法是,如果你把 AI 和量子计算结合起来,也许你可以用量子计算生成合成数据,再由 AI 用来训练更出色的模型,让这些模型学会模拟化学、物理或其他类似领域。这两者将被结合使用。
所以即使在今天,我们实际上也在用 HPC 和 AI 的结合来做这件事。我希望未来能用量子计算机替代其中的一些 HPC 部分。
你能稍微讲讲,在微软这种规模的公司里,你是如何做那些将在 20 年、30 年后才真正带来回报的研究决策的吗?显然,你对这个项目的技术细节非常了解。但对于微软研究院做的所有事情,你都能做到这一点吗?
你怎么知道现在押的注会在 20 年后得到回报?它是必须自然而然地通过组织内部涌现出来的,还是说你是如何追踪这一切的?
我觉得非常棒的一点是,Bill 大概在 1995 年创办了 MSR。在这些由好奇心驱动的研究机构的长久历史中,纯粹去做一个专注于基础研究的组织,而 MSR 这些年来积累起了这种制度上的力量。所以当我考虑资本配置或预算时,我们首先把筹码押上,说:「这是 MSR 的预算。」我们每年都必须这样做,同时心里清楚,这些赌注中的大多数在任何有限的时间框架内都不会得到回报。也许微软的第六任 CEO 会从中受益。而在科技行业,我认为这是理所当然的。
我真正思考的是,当量子计算或某种新模型等时机成熟时,你能否把握住机会加以利用?因此,作为现有巨头,如果你回顾科技史,问题不在于人们没有投资,而在于你需要拥有一种文化,知道如何把一项创新放大规模。
坦白说,这正是 CEO 和管理团队最难的部分。这很有意思。这既关乎良好的判断力,也关乎良好的文化。有时候我们做对了,有时候做错了;我可以告诉你 MSR 有一千个项目,我们本应该率先推进,但我们没有。我总是在问自己为什么。那是因为我们没能获得足够的信念,也没能把思路想完整:如何不仅把创新拿出来,还要把它变成一个有用的产品,配上一个商业模式,然后推向市场。
这就是 CEO 和管理团队的工作:不只是对某一件事感到兴奋,而是能够真正把一件完整的事执行落地。这说起来容易做起来难。
你提到了微软接下来可能再有三任 CEO,如果他们每个人都让市值提升一个数量级,那么等到下一次突破出现时,微软的规模可能就像世界经济那么大了。
或者说别忘了,世界经济的增速会达到 10%,所以我们没问题。
我们来深入聊聊你们刚刚取得的另一项重大突破。令人惊讶的是,这两项成果在同一天发布,就是你们在游戏世界模型上的进展。我很想听你讲讲。
我们会把它叫做 Muse。它将成为这个世界动作,或者说人类动作模型。
这非常酷。显然,DALL-E 和 Sora 在生成模型方面的能力令人难以置信。我们想要攻克的一点是使用 gameplay 数据。你是否真的能生成既保持一致性、又能展现游戏所代表的多样性,并且对用户模组具有持久兼容性的游戏?
这就是 Muse 在做的事。他们得以与我们旗下的一个游戏工作室合作,这也是另一篇发表在 Nature 上的论文。
让我兴奋的一个很酷的事情是,我们很快就会有一份游戏目录,我们将开始使用这些模型——或者说训练这些模型来生成游戏,然后开始玩它们。
事实上,当 Phil Spencer 第一次给我展示时,他拿着一个 Xbox 手柄,这个模型基本上接收输入,然后根据输入生成输出。而且它与游戏保持一致。对我来说,这是一个让人大呼「哇」的重大时刻。就像我们第一次看到 ChatGPT 补全句子,或者 DALL-E 画画,又或者 Sora 生成视频一样。这是又一个这样的时刻。
今天早上,我和你们的首席研究员 Katja 一起看了实时演示的一些视频。直到和她聊过之后,我才真正意识到这有多不可思议。我的意思是,过去我们用 AI 来建模智能体,而仅仅是把同样的技术用来建模智能体周围的世界,就能产生一致的实时效果——我们会把这段视频的画面叠加在这期播客上,让大家有机会亲眼看到。我猜到时候视频应该已经发布了,所以他们也可以去那里观看。
这本身就令人难以置信。你在担任 CEO 期间,已经投入了成百上千亿美元来建设微软游戏并收购 IP。
回想起来,如果你能把所有这些数据合并成一个大模型,让你获得同时访问和穿越多个世界的体验,而如果这就是游戏的发展方向,那么这笔投资看起来相当划算。你对此有过什么预感吗?
我不会说我们投资游戏是为了建造模型。坦白说,我们投资游戏是因为——我们的历史中有件有趣的事:我们在打造 Windows 之前就做出了第一款游戏。Flight Simulator 在微软甚至还没做出 Windows 之前就已经是微软的产品了。
所以,游戏在公司有着悠久的历史,我们投身游戏就是为了游戏本身。我一贯的主张是,我讨厌从事那些只是达成其他目的之手段的业务。它们本身就必须是目的。
然后,是的,我们不是一家企业集团。我们是一家必须把各种资产整合起来,并通过创造价值成为更好所有者的公司。例如,云游戏是我们很自然会投资的领域,因为这会扩大 TAM,也能让人们随时随地玩游戏的能力变得更强。
AI 和游戏领域也是如此:我们确实认为,AI 可能有助于带来某种变革——从长远来看,这甚至有点像游戏行业的 CGI 时刻。这很棒。作为规模最大、全球最大的发行商,这将有所帮助。但与此同时,我们必须打造出高质量的游戏。我的意思是,作为一家游戏发行商,你首先且最重要的,某种程度上就必须专注于此。
但这项数据资产将会很有意思,它不仅限于游戏场景,还将成为一个通用的行动模型和世界模型,这太棒了。我是说,你知道,我认为游戏数据对微软而言,或许就像 YouTube 之于谷歌。因此,我对此感到兴奋。
是的,我就是这个意思,也就是说,你可以在许多不同类型的游戏中获得统一的体验。这如何与微软过去所做的其他事情相契合?撇开 AI 不谈,还有像 mixed reality 这样的技术?也许能让小型游戏工作室有机会打造这些 AAA 级别的动作游戏?展望未来五到十年,你能想象到哪些可能性?
我把这三件事视为基石。说来有趣,早在五六七年前,我就说过我们要押的三个大注是 AI、quantum 和 mixed reality。我现在仍然相信它们,因为从某种意义上说,有哪些重大问题是亟待解决的?
临场感。这是 mixed reality 的梦想。你能创造出真正的临场感吗?就像你和我现在这样录播客一样。
说实话,我认为这仍然是那些挑战中更难的一个。我原以为它会更容易解决。也许恰恰因为社会层面的因素——比如要穿戴设备等——它才更困难。
事实上,我们对即将与 Anduril 和 Palmer 合作、乃至他们将如何推进 IVAS 项目感到兴奋,因为那是一个绝佳的用例。因此,我们会继续推进这方面的工作。
但同时,还有 2D 屏幕。事实证明,像 Teams 这样的产品,对吧,多亏了疫情,我们确实已经获得了即便通过 2D 也能本质上创造临场感的能力。而且我认为这将会持续下去。这是一个长期的结构性趋势。
刚才谈到了 quantum,另一个是 AI。所以当我审视这三样东西时,我会说,如何将它们融合在一起?归根结底,不是为了技术而技术,而是解决一些我们作为人类在生活中最基本的需求,更进一步说,我们希望它们在经济中发挥作用,驱动我们的生产力。因此,如果我们能以某种方式把这些做对了,我想我们就真的取得了进步。
当你写下一本书时,你得解释一下为什么这三块技术会大致在同一时间汇聚,对吧?我是说,你并没有一个内在的理由去认为 quantum 和 AI 就应该分别在 2028 年、2025 年之类的节点上出现。
没错。在某种程度上,我看待它的方式是:我有一个简单的模型,那就是,是否存在系统层面的突破?对我来说,系统层面的突破就是 quantum 这件事。
是否存在商业逻辑层面的突破?对我而言,那就是 AI,也就是说:逻辑层能否从根本上以不同的方式被推演?能否不再通过命令式地编写代码,而是拥有一个学习系统?这就是 AI 所代表的那个。
先回到 AI,在你 2017 年的书里……你在 2019 年投资了 OpenAI,非常早,2017 年甚至更早,你在书中写道:"人们也可以说,我们正在孕育一个新物种,一个其智能可能没有上限的新物种。"
当然,在 2017 年就谈论这些是非常超前的。我们一直在非常具体地讨论 agents、Office Copilot、capex 等等。但如果你把视野放大,想想你做出的这个论断,再想想你作为 hyperscaler 的身份,你同时也在研究这些模型,为构建一个新物种提供训练、推理和研究支持,在宏大的图景中,你是怎么看待这件事的?
你认为在你的 CEO 任期内,我们会走向超人类智能吗?
我觉得连 Mustafa 都在用那个说法。事实上,他最近也用过"新物种"这个词。
我的切入点是,你肯定需要信任。在我们宣称它是如同物种一般重大的事物之前,我们必须解决的根本问题是,要内置真正的信任,无论是个人层面还是社会层面的信任。这才是难题所在。
我认为,要让这种能力真正释放,最大的瓶颈在于我们的法律……不妨称之为基础设施。我们都在谈论算力基础设施,但法律基础设施将如何演变以应对这一切?整个人类世界的建构基础是人类拥有财产、享有权利并承担责任。这是一个人首先必须搞清楚的根本问题:好吧,这对人类如今用作工具的一切事物意味着什么?如果人类要将更多权力委托给这些东西,那么这种结构将如何演变?在这些问题真正得到解决之前,我觉得仅仅谈论技术能力是行不通的。
也就是说,在我们弄清楚如何……之前,我们将无法部署这类智能?
完全正确。因为说到底,这是不可能的。在今天,你无法部署这些智能,除非且直到有人作为人类为其承担赔偿责任。
顺着你的话说,我认为这就是为什么我觉得,即便是最强大的 AI,本质上也是在以某种从人类处获得的委托授权运作。你可以说,哦,这全是 alignment 之类的。正因如此,我认为你必须真正让这些 alignment 生效,并以某种方式可验证,但我就是觉得你不能部署那些失控的智能。例如,这个 AI takeoff 问题可能确实是个问题,但在它成为真正的问题之前,真正的问题将出现在法庭上。没有哪个社会会允许某个人说:"是 AI 干的。"
是的。可是,世界上有很多社会,我在想是否其中某个社会的法律体系可能更宽松易行。如果 takeoff 无法发生,那你可能会感到担忧。不一定非发生在美国,对吧?
我认为没有哪个社会不在乎这一点,对吧?可能会有流氓行为者,我不是说不会有;网络犯罪分子和流氓国家存在,他们会在那里。
但认为人类社会整体不在乎它,这也不可能是真的。我认为我们都会在乎。我们今天知道如何对付流氓国家和流氓行为者。世界不会坐视不管,说"我们容忍这个"。正因如此,我很高兴我们拥有一个世界秩序,任何身处流氓国家的流氓行为者都要承担后果。
没错。但如果你设想这样一种图景:你可以实现 10% 的经济增长,我认为这真的取决于能否让类似 AGI 的东西运转起来,因为数万亿美元的价值,听起来更接近人类工资总额,大约相当于经济体量中的 60 万亿美元。要达到那种量级,你必须在某种程度上大规模地自动化劳动,或以非常重要的方式补充劳动。
如果这是可能的,而且一旦我们弄清楚了其法律后果,那么甚至在你的任期内解决这些问题,看起来都是相当合理的。你在考虑超人类智能吗?我是说,你职业生涯中做的最重要的事就是这个?
你提出了另一个很好的观点。我知道 David Autor 等人多次谈到过这个问题,也就是 60% 的劳动力——我认为还有一个必须讨论的问题,至少在我们的民主社会中是这样。我认为,为了拥有稳定的社会结构,为了让民主制度正常运转,你不能只有资本回报而没有劳动回报。我们可以讨论这个问题,但那 60% 必须被重新估值。
用我自己简单的方式——或许你可以称之为天真——我们将开始重视不同类型的人类劳动。如今被视为高价值的人类劳动可能会变成大宗商品。也许会出现我们重新珍视的新事物。
包括那些前来帮我做物理治疗或诸如此类的人,无论我们最终会珍视的是什么,但归根结底,如果我们没有劳动回报,如果工作缺乏意义、缺乏尊严等等,那这本身就是限制所有这些技术部署的另一大瓶颈。
在 alignment 方面,两年前你们发布了 Sydney Bing。先说明一下,我认为鉴于当时的能力水平,那是一个迷人、可爱、又有点好笑的 misalignment 案例。
但那是因为在当时,它就像是聊天机器人。它们可以思考 30 秒,然后给出一些好笑或不恰当的回答。但如果你展望未来,想想那种系统——我记得它曾对一名《纽约时报》记者试图劝说他离开妻子之类——如果你继续往前想,你会拥有这些能持续运行数小时、数周、数月的 agent,就像自主的 AGI 集群,它们可能以类似的方式出现 misaligned 并搞砸事情,甚至可能彼此协调,你们未来有什么计划,确保当你们做出那个重大成果时,能一次做对?
没错。这就是为什么我们在分配算力时,要把算力用在应对那个 alignment 挑战上的原因之一。
然后更重要的是,你究竟要在什么样的运行时环境(runtime environment)中才能真正监控这些东西?围绕它的可观测性(observability)如何?我们今天在传统领域也要处理很多这类问题,比如网络安全(cyber)。我们不会写完软件就放任不管。你拥有软件,然后你要监控它。你要监控网络攻击,监控故障注入(fault injection),诸如此类。
因此,我认为我们必须围绕这些系统的部署端建立起足够的软件工程能力,然后在模型本身内部,alignment 的问题怎么解决?这些问题中,有些是真正的科学问题,有些是真正的工程问题,我们都必须去攻克。
这也意味着我们要为这一切承担自己的责任。所以我更感兴趣的是,在那些能够真正管控这些东西的范围和规模的场景下部署它们。你绝不能把某种会造成伤害的东西释放到世界上,因为社会不会允许你这么做。
当你拥有真正能为你连续执行数周任务的 agent 时,在让它去运营一家随机的《财富》500 强公司之前,你所需的最低保障是什么?
我认为,即便在使用像 Deep Research 这样的产品时,我们想要的最低保障是,特别是在任何东西拥有 physical embodiment 之前——我觉得那算得上是你跨越的某个门槛之一。那可能就是一个关键节点。
另一个则是,例如,它运行的运行时环境(runtime environment)的权限。你可能需要确保它被 sandbox(沙盒化),不会逃出那个 sandbox。
我是说,我们已经有了网络搜索,而且它已经在 sandbox 之外了。
但即便是它通过网络搜索做什么、写什么——比如你提到的,如果它要编写一堆代码来进行某种计算,那段代码部署在哪里?那段代码是否只是为了生成那个输出而短暂存在(ephemeral),还是会被释放到全世界?
这些都是在 action space 中你实际上可以去控制的事情。
抛开安全问题不谈,当你思考自己的产品组合时,如果你确实拥有如此强大的 AI,到了某个阶段,它就不只是像 Copilot 那样——你提到过你是如何用它准备这期播客的——而是更像你实际把工作委派给同事那样。
鉴于你们目前的产品组合,加入这种能力会是什么样子?我是说,有一个问题是 LLM 是否会被其他东西 commodify。
我想知道,如果这些数据库、canvas、Excel 表格或其他东西——如果 LLM 是你访问所有这些事物的主要入口——有没有可能 LLM 反而会让 Office 被 commodify?
这是个有趣的问题。至少我认为第一阶段会是:LLM 能否帮助我更有效地利用所有这些工具或 canvas 来完成知识工作?
我见过最棒的演示之一是一位医生准备 tumor board 的工作流。她要参加一场 tumor board 会议,而她用 Copilot 做的第一件事就是创建会议议程,因为 LLM 会帮助推理所有病例——这些病例存在某个 SharePoint 站点里。它会说:“嘿,这些病例——显然,tumor board 会议是一场高风险的会议,你需要留意病例之间的差异,这样才能合理分配时间。”
就连这种创建议程并懂得合理分配时间的推理任务——太棒了。所以我用 LLM 来做这个。然后我进入会议,在 Teams 上和所有同事通话。我专注于实际的病例,而不是记笔记,因为你现在有这个 AI Copilot 在做完整的全程转录。这不只是转录稿,而是把会议内容变成一条可随时调取的数据库记录,永久可查。
接着她开完会,讨论完了病例,也没有被记笔记分心。她是一名教学医生;她想去准备自己的课程。于是她打开 Copilot 说:“把我的 tumor board 会议内容拿出来,做成一套 PowerPoint 幻灯片,这样我就可以跟学生讲了。”
这就是那种类型的应用。我现有的 UI 和 scaffold 都是 canvas,现在它们正被 LLM 填充内容。工作流本身也在被重塑;知识工作正在被完成。
有趣的是:如果有人在 80 年代末跟我说,“你的桌面上会有一百万份文档,”我会说,“那到底是什么鬼?”我真的会以为我桌上会堆满一百万份纸质复印件。但实际上,我们确实拥有一百万个电子表格和一百万份文档。
它们都在那里。所以,即便对于 agent,也会发生同样的事情。会有一个 UI 层。对我来说,Office 不只关乎今天的办公室;它是知识工作的 UI 层。它会随着工作流的演变而演变。这就是我们要构建的东西。
我确实认为,今天存在的这些 SaaS 应用,这些 CRUD 应用,将会发生根本性的改变,因为业务逻辑会更多地进入这个 agentic 层。事实上,我今天在 Copilot 体验中另一件很酷的事情是,当我说“嘿,我要准备和客户开会,”我直接说“把我要知道的所有相关笔记给我。”它从我的 CRM 数据库拉取,从 Microsoft Graph 拉取,创建一个复合的、本质上的 artifact,甚至还在上面应用逻辑。对我来说,这将改变我们今天所知的 SaaS 应用。
SaaS 作为一个行业,每年可能价值数千亿到数万亿美元,取决于你怎么计算。如果真的能被 AI 压缩整合,那么你们下一步在未来十年是不是又要让 Microsoft 的市值再翻十倍?因为你聊的是数万亿美元……
这也会为 SaaS 创造大量价值。也许有一件事我们没有充分关注,那就是世界上积压的 IT 需求有多大。
这些 code gen 工具,加上我可以用 agent 去查询你所有 SaaS 应用并获得更高实用价值的事实,将带来应用有史以来最大规模的爆发——它们会被称为 agent——这样一来,在每个垂直领域、每个行业、每个品类,我们突然都能获得服务的能力。
所以这其中将蕴含巨大价值。你不能原地不动,也不能再说那种老话了:“哦,我把某个狭窄的业务流程做了图式化,我在浏览器里有一个 UI,这就是我的东西。” 以后不会是这样了。你必须向更上层拓展,然后问:“我需要参与完成的任务是什么?”
你会希望能够把自己的 SaaS 应用打造成一个出色的 agent,让它参与到一个多 agent 的世界中。只要你能做到这一点,我认为你甚至还能提升价值。
我能问几个关于你在 Microsoft 经历的问题吗?
做一个“公司人”是否被低估了?你的职业生涯大部分时间都在 Microsoft 度过,可以说你能创造如此多的价值,原因之一就是你见证了它的文化、历史和技术。你通过一步步晋升,积累了所有这些背景信息。是否应该有更多公司由具备这种程度背景的人来管理?
这是个好问题。我从未这样想过。
在 Microsoft 的这 34 年里,每一年我都对身处其中感到更加兴奋,而不是想着“哦,我是一个公司人”之类的。我很认真地对待这一点,甚至对于任何加入 Microsoft 的人来说也是如此。并不是说他们加入 Microsoft 就是在签卖身契,只要他们觉得可以把这里当作一个平台,既能获得经济回报,也能通过使用我们这个平台来实现一种使命感和目标感。这就是契约。
所以我认为,是的,公司必须创造一种文化,让人们加入进来,成为像我这样的“公司人”。Microsoft 做得对的比错的多,至少对我个人而言是这样,我也希望这种情况能持续下去。
你说的第六任 CEO,也就是将能使用你们现在开启的研究成果的那位,你们正在做什么来留住未来的 Satya Nadella,让他们有机会成为未来的领导者?
这很有意思。今年是我们成立 50 周年,我经常思考这件事。思考方式应该是:长期存在不是目标,保持相关性才是。
我和我们所有 20 万人每天必须做的事是:我们所做的事是否对这个世界有用、是否相关?不仅要看今天,还要看明天,看我们所预见的世界演变方向。
我们身处一个没有特许价值的行业,所以这是另一个艰难之处。如果你看看我们今年将投入的 R&D 预算,那全都是在赌五年后会发生什么。你必须带着这样的态度去做,说:“我们正在做的事,是我们认为未来会相关的。”
所以这就是你必须专注的。然后要知道,这里有一个成功率的问题,你不可能每次都成功——你必须对失败有很高的容忍度。你必须有足够多的尝试,才能说:“好吧,我们作为一家公司会走到对岸。” 这就是这个行业棘手的地方。
说到这个——你刚提到离 Microsoft 成立 50 周年还有两个月。如果你看看按市值排名的前 10 大公司,或者前 5 大,基本上除了 Microsoft,其他所有公司都比 Microsoft 年轻。这是一个有趣的观察,即为什么最成功的公司往往相当年轻。一家 Fortune 500 公司的平均寿命只有 10 到 15 年。
Microsoft 做了什么才能这么多年保持相关性?你们是如何不断重新创立的?
我很喜欢这个说法,Reed Hoffman 用了“refounding”这个词。这就是那种心态。人们谈论创始人模式(founder mode),但对我们这些凡人 CEO 来说,这更像是再创始人模式(refounder mode)。
能够以全新的方式重新审视事物是关键。针对你的问题:我们能否在文化上创造一种环境,让“重新创立”成为一种习惯?每天我们走进来说:“我们觉得自己在这个地方拥有切身利益,能够改变我们做事的核心假设,以及我们如何与周围世界互动。我们允许自己这样做吗?” 我认为很多时候,公司会觉得受到商业模式或其他因素的过度束缚。你只需要把自己从束缚中解放出来。
如果你离开 Microsoft,你会创办一家什么样的公司?
我会创办什么样的公司?天哪。这时候那个“公司人”的我就出来说了:“我永远不会离开 Microsoft。”
如果我真的在考虑做点什么,我会选择一个拥有……当我审视技术的梦想时,我们一直都讲,技术是最伟大、最宏大的民主化力量。
我感觉我们终于拥有了这种能力。如果你说我们能产出的就是那些每美元每瓦特的 token,我很希望找到某个应用领域来部署它,而那个领域又如此缺乏服务。
那就是医疗、教育……公共部门会是另一个领域。如果你看看这些领域,它们都是服务不足的地方,作为这个国家的公民或这个社会的一员,如果所有这些富足能以某种方式转化为更好的医疗、更好的教育,以及更好的公共服务机构来为我这样的公民服务,我的生活会不会变得更好?那就会是一个合适的领域。
听你回答不同的问题时,有一点我不太确定,那就是你认为 AGI 会是一个确定存在的事物吗?会不会出现一种东西,能自动化所有认知劳动,就像任何人在电脑上能做的任何事情一样?
这正是我对人们谈论它的方式在定义上有疑问的地方。认知劳动不是一个静态的东西。今天存在认知劳动。如果我有一个收件箱在管理我所有的 agent,这算不算新的认知劳动?
今天的认知劳动可能被自动化。但那些被创造出来的新认知劳动呢?这两件事都必须考虑,这就是那种转变……
这就是为什么我在脑子里至少会做这样一个区分:不要把知识工作者和知识工作混为一谈。今天的知识工作可能可以被自动化。谁说我的人生目标是去筛选邮件?让 AI agent 去整理我的邮件吧。
但在整理完邮件之后,给我一个更高层次的认知劳动任务,比如:“嘿,这三份草稿我真的想让你审阅一下。” 这是一种不同的抽象层级。
但 AI 有朝一日能做到第二件事吗?
它可能会,但一旦它做到了第二件事,就会有第三件事。为什么我们会认为,当我们已经经历过那些在历史上改变了认知劳动本质的工具之后,还要担心所有认知劳动都会消失?
我相信你以前听过这些例子,马在某些事情上仍然可以派上用场,有些地形你没法开车进去。但要说你会在街上看到成群的马,会雇佣数百万匹马,这就不太可能了。
然后这个想法就是,人类身上会发生类似的事情吗?
但在一个非常狭窄的维度上?人类重视我们所说的这种“认知劳动”,也不过才 200 年的历史。
我们拿化学来举例。如果量子计算加上 AI 真的能帮助我们做出很多新颖的材料科学之类的东西,由它来完成新颖的材料科学,这太棒了。但这会剥夺人类能做的所有其他事情吗?
为什么我们不能存在于一个拥有强大认知机器的世界里,同时知道我们的认知能动性并没有被剥夺?
我会问这个问题,不是关于你个人,而是换一个场景,这样你也许可以回答得不那么尴尬。假设在 Microsoft 的董事会里,你能想象加入一个 AI 吗?它是否可能拥有足够的判断力、背景知识和整体性理解,从而成为一个有用的顾问?
这是一个很好的例子。我们在 Teams 里增加的一个东西就是 facilitator agent。它的目标——目前还处于早期阶段——是这个 facilitator agent 能否利用长期记忆,不仅是基于会议的上下文,还能基于我正在做的项目、团队等等的上下文,来成为一个出色的会议引导者?
即使是在董事会会议上,我也很希望能有这样东西,因为在那种场合人们很容易走神。毕竟,董事会成员一季度才来一次,而他们正努力理解像 Microsoft 这样一家复杂公司所发生的一切。一个 facilitator agent 能够切实帮助所有人始终围绕主题、聚焦于真正重要的问题,这太棒了。
这差不多就等于是——回到你之前的问题——拥有某种具备无限记忆、甚至能够帮助我们的东西。毕竟,Herbert Simon 那句话是怎么说的来着?我们都是有限理性的。所以,如果人类的有限理性真的能够因为外部存在一个认知放大器而得到解决,那就太好了。
说到材料和化学方面的东西,我记得你最近说过,你希望这两个领域未来250年的进步能在接下来的25年里实现。那么,当我展望未来的250年,我想的是太空旅行、太空电梯、永生、治愈所有疾病。接下来的25年,你觉得呢?
我提起这一点的原因之一是,我很喜欢这样一种观点:工业革命本身就是那250年的进程。我们必须完成从碳基体系向某种不同体系的全面转变。这意味着你必须从根本上重新发明过去250年里化学领域所取得的一切成果。这就是我寄望于量子计算机的地方,希望这种量子计算机帮助我们获得新材料,然后我们可以制造这些新材料,以应对这个星球上的所有挑战。之后,我完全支持星际旅行。
太棒了。Satya,非常感谢你抽出时间。
非常感谢。这次对话很愉快。谢谢。